
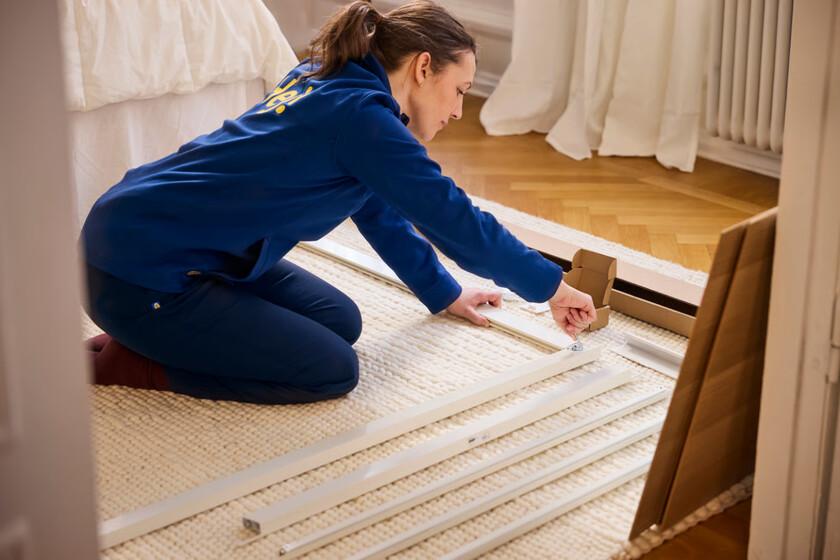
Si alguna vez has terminado de montar un mueble de IKEA con una pieza de más sobre la mesa y la sospecha de haber hecho algo mal, ahora tienes un aliado inesperado: la inteligencia artificial. El laboratorio de investigación Epoch AI, conocido por sus exigentes benchmarks matemáticos, ha creado el Furniture Assembly Benchmark (FAB), una prueba tan sencilla de entender como reveladora sobre las capacidades reales de los modelos de IA actuales.
La metodología es tan curiosa como efectiva: el equipo de Epoch compró tres muebles de IKEA, los fue montando y, deliberadamente, introdujo errores a propósito en distintos puntos del proceso. Después fotografiaron el resultado y se lo mostraron a diferentes modelos de IA junto con el manual de instrucciones oficial, pidiéndoles que determinaran si el montaje era correcto y, si no lo era, que localizaran exactamente dónde estaba el fallo. Para complicar aún más las cosas, en ocasiones el equipo siguió montando el mueble después de cometer el error, de forma que este no quedara como el último paso visible, obligando a la IA a rastrear hacia atrás en la secuencia de montaje.
Los resultados muestran una mejora meteórica. En noviembre de 2025, el modelo más avanzado disponible, Claude 4.5, apenas acertaba un 28% de las veces. Diez meses después, en septiembre de 2026, GPT-6 Astra ha elevado esa cifra hasta un sorprendente 80% de aciertos, y además lo hace mucho más rápido: una media de tres minutos por fotografía, entre dos y diez veces menos que los modelos que antes encabezaban la tabla. Para completar la tarea, los modelos disponen de una herramienta para hacer zoom sobre zonas concretas de la imagen y un intérprete de Python que les ayuda a procesar la información visual y numérica.
Más allá de la anécdota de los muebles suecos, lo que Epoch AI realmente quiere medir es algo mucho más profundo: la capacidad de razonamiento abstracto de la IA, es decir, si es capaz de conectar instrucciones simbólicas de un manual con objetos reales fotografiados desde ángulos imperfectos. Es una habilidad que resulta relativamente sencilla de evaluar en matemáticas o programación, donde hay una respuesta objetivamente correcta, pero muchísimo más difícil de medir cuando entra en juego la visión espacial aplicada al mundo físico. Si algún día queremos una IA capaz de ayudarnos a reparar un coche o un electrodoméstico siguiendo un manual técnico, este tipo de razonamiento será imprescindible.
Curiosamente, el estudio también reveló sesgos distintos según la familia de modelos: Gemini y Qwen tendían a ‘ver fantasmas’, señalando errores en montajes que en realidad eran correctos, mientras que versiones anteriores de OpenAI y Anthropic pecaban de lo contrario, dando el visto bueno a montajes defectuosos. Esto conecta con la vieja paradoja de Moravec, que señala que lo que es trivial para un humano (ver si un mueble está bien montado) puede ser tremendamente difícil para una máquina, y viceversa. Para la comunidad geek, siempre ávida de nuevos benchmarks curiosos y virales, el FAB es un ejemplo perfecto de cómo la ciencia de la IA puede ser rigurosa y divertida a partes iguales, aunque conviene recordar que estamos todavía muy lejos de tener un robot capaz de montarnos el armario Pax sin ayuda humana.